

UniWorld: un nuovo standard open-source per comprendere e modificare le immagini | Midjourney ai | Generatore di immagini gratis online | Buon giovedì allegro | Turtles AI
UniWorld: un nuovo standard open-source per comprendere e modificare le immagini
Un framework unificato che unisce percezione, generazione e editing visivo con codificatori semantici ad alta risoluzione, superando modelli specialistici e aprendo la strada a nuove applicazioni pratiche
Editorial Team5 giugno 2025
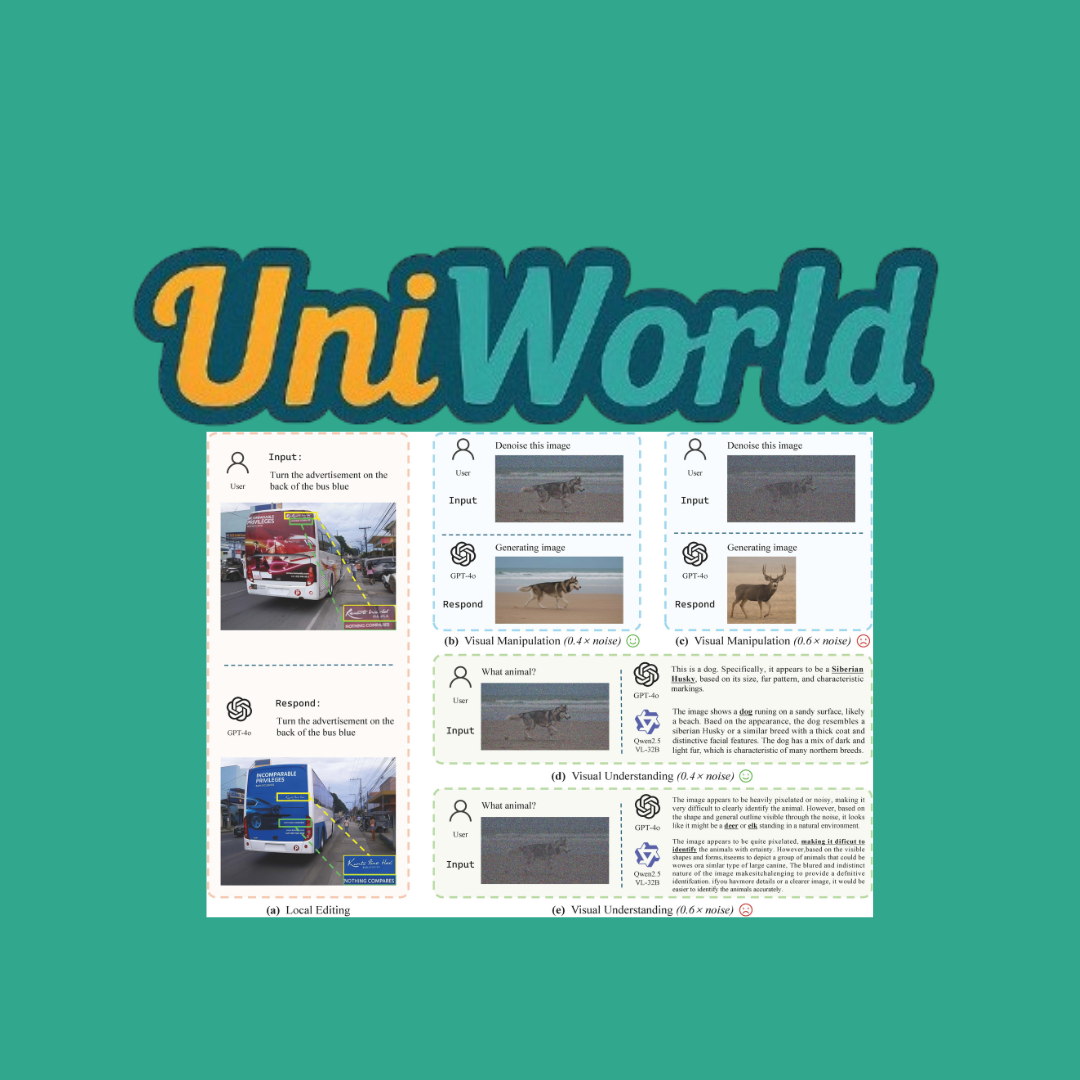
UniWorld è un framework open‑source che integra comprensione, generazione e modifica di immagini utilizzando codificatori semantici ad alta risoluzione. Addestrato su 2,7 M di immagini, supera modelli specialistici sul benchmark ImgEdit‑Bench e copre oltre 20 task CV.
Punti chiave:
- Framework unico per comprensione, generazione e editing di immagini.
- Addestrato con soli 2,7 M di dati e dati open source già disponibili.
- Utilizzo di codificatori visivi contrastivi ad alta risoluzione anziché VAE.
- Supera costantemente BAGEL e Step1X‑Edit in operazioni di editing su ImgEdit‑Bench.
UniWorld, presentato in un recente preprint su arXiv, propone un’architettura unificata che combina compiti di percezione visiva, generazione e modifica, liberandosi dall’approccio a compartimenti stagni. Nonostante l’uso di un dataset relativamente compatto (2,7 M di esempi), incluse 286 000 didascalie generate via Qwen2‑VL‑72B e 724 000 esempi di editing filtrati con GPT‑4o, il sistema dimostra risultati superiori a modelli specialistici. In particolare, nel benchmark ImgEdit‑Bench UniWorld batte costantemente BAGEL e il modello Step1X‑Edit su operazioni complesse quali aggiunta, regolazione ed estrazione.
Il motore della sua efficacia risiede nell’impiego di codificatori semantici contrastivi ad alta risoluzione: all’aumentare della risoluzione, le feature globali vanno in saturazione, lasciando spazio a dettagli localizzati fondamentali nel mantenere la fedeltà durante l’editing. Questa scelta si contrappone ai VAE utilizzati nei metodi convenzionali, spesso inadeguati a preservare i dettagli finissimi.
UniWorld capitalizza inoltre sull’integrazione delle capacità multimodali dei moderni modelli linguistici–visivi (VLM): le istruzioni testuali e le immagini vengono codificate dal medesimo VLM, senza dover apprendere token aggiuntivi. Il formato causale
Il sistema si mostra versatile in più di 20 attività di computer vision: dall’analisi semantica ai compiti di schizzo (sketching), MLSD, segmentazione e quant’altro, dimostrando robustezza e affidabilità su compiti distinti. UniWorld è completamente open source: pesi, dataset, strumenti di training e valutazione sono liberamente disponibili, favorendo trasparenza e riproducibilità.
Il preprint conferma come, sotto lo stimolo delle intuizioni di OpenAI sul GPT‑4o‑Image – anch’esso basato su codificatori semantici piuttosto che VAE – la comunità si stia dirigendo verso rappresentazioni visive più semantiche che pixel‑centriche. UniWorld eredita e concretizza questa visione, dimostrando che una pipeline con meno dati, senza VAE e centrata su codificatori contrastivi ad alta risoluzione basta a trainare un framework unificato, potente e aperto.
Una riflessione conclusiva: UniWorld rappresenta un avanzamento significativo nel percorso verso sistemi visivi generativi e percettivi integrati, favorendo l’esplorazione aperta e collaborativa grazie all’accessibilità totale dei suoi componenti.