

Lynx, il soffio che anima la fotografia: dall’immagine ferma al racconto in movimento | | | | Turtles AI
Lynx, il soffio che anima la fotografia: dall’immagine ferma al racconto in movimento
Un modello che dà respiro ai volti: un solo scatto diventa sequenza viva, fedele ai tratti e colma di dettagli che accompagnano lo sguardo fotogramma dopo fotogramma
Editorial Team28 settembre 2025
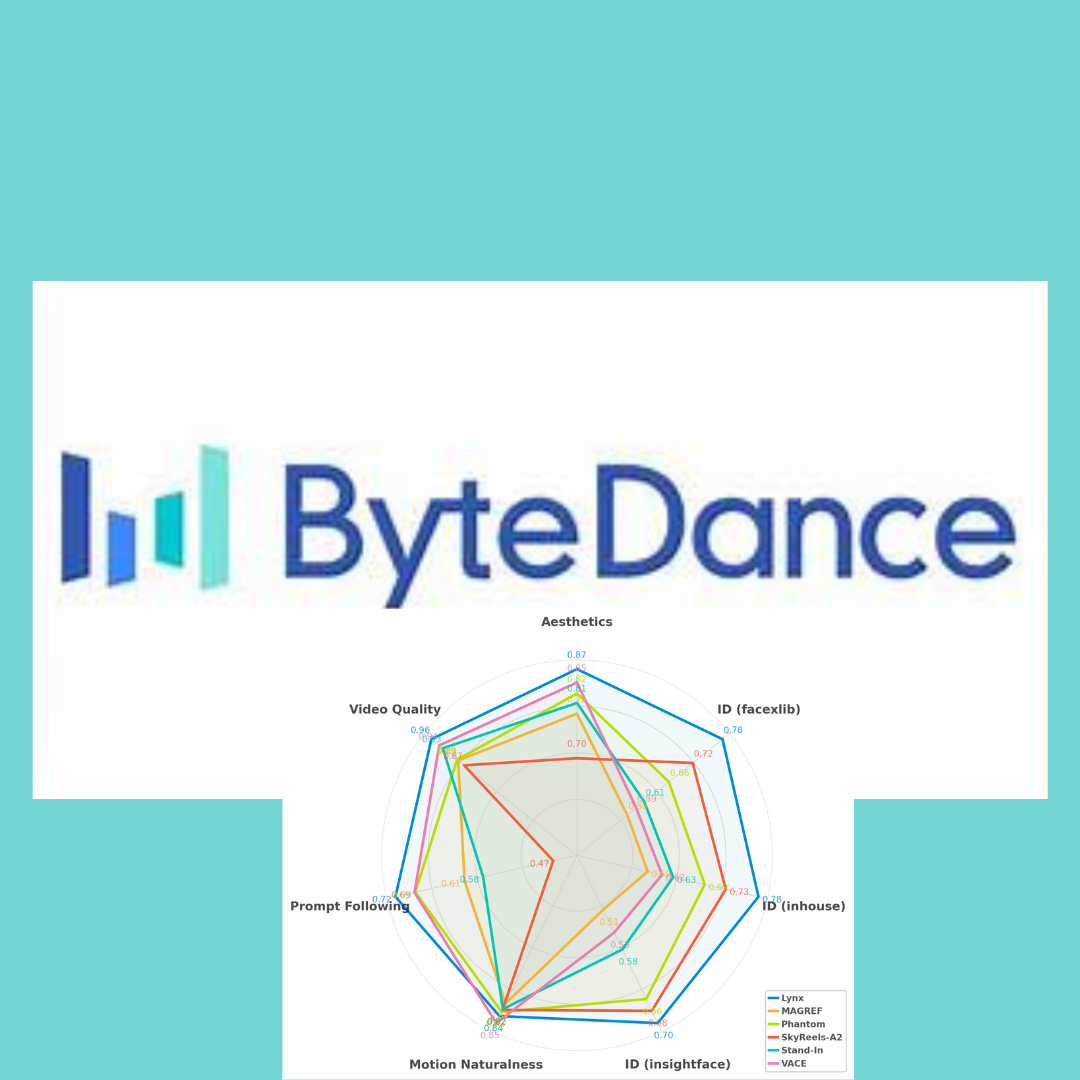
Lynx trasforma una singola fotografia in video realistici mantenendo l’identità del soggetto costante. Si appoggia a un modello Diffusion Transformer (DiT) potenziato da due adattatori leggeri: l’uno per l’identità (ID) e l’altro per i dettagli (Ref). I risultati mostrano somiglianza facciale elevata, fedeltà al prompt e qualità visiva superiore.
Punti chiave:
- Un solo input fotografico + prompt → generazione video coerente
- ID-adapter: embedding facciali compatti per conservare l’identità
- Ref-adapter: iniezione di dettagli fini tramite attenzione incrociata
- Su benchmark di 800 casi, ottima somiglianza facciale e forte allineamento al prompt
Lynx emerge come progetto recente nel panorama dell’AI generativa: sviluppato da ByteDance, mira a colmare il divario tra immagini statiche e sequenze video realistiche preservando il volto del soggetto in ogni fotogramma. Il modello di base è un Diffusion Transformer open source, su cui sono innestati due moduli specializzati l’adattatore ID e l’adattatore Ref che insieme cooperano per stabilizzare l’identità e mantenere coerenza spaziale e temporale.
L’adattatore ID utilizza un Perceiver Resampler che trasforma embedding facciali ottenuti da un riconoscitore (ArcFace) in token compatti di identità, che illustrano le caratteristiche strutturali distintive del volto. Questi token vengono poi impiegati per condizionare il generatore, guidando la coerenza identitaria durante il processo diffusionale. Parallelamente, l’adattatore Ref sfrutta caratteristiche dense estratte da un percorso di riferimento congelato (ovvero non aggiornato durante il training), tramite una codifica VAE, e le inietta in ogni livello del trasformatore tramite meccanismi di attenzione incrociata. In questo modo, dettagli come texture della pelle, capelli, contorni sottili e tratti minuti vengono conservati fedelmente nel video generato.
Durante l’addestramento, Lynx adotta una strategia progressiva: inizia da immagini singole (trattate come video di lunghezza 1) per apprendere la preservazione dell’identità e successivamente si espande su sequenze video reali per modellare il movimento, l’allineamento temporale e la continuità visiva. Per gestire input con risoluzioni e durate diverse, viene usata una tecnica che concatena token di video diversi in sequenze lunghe, separabili tramite maschere di attenzione, garantendo isolamenti tra campioni distinti. Anche l’augmentazione del volto (variazioni d’espressione) e la rimodellazione dell’illuminazione del ritratto aiutano a rendere il modello robusto alle condizioni reali.
Il lavoro è stato valutato su un benchmark costruito con 40 soggetti e 20 prompt imparziali, producendo 800 casi di test. Per misurare la somiglianza del volto si sono usati tre modelli indipendenti (due ArcFace e uno interno). I risultati mostrano che Lynx supera gli altri metodi in termini di preservazione identitaria, mantiene prestazioni competitive nel seguire il prompt, e ottiene qualità video elevata secondo metriche estetiche, naturalezza del movimento e qualità complessiva. Viene inoltre messo in evidenza che approcci concorrenti spesso soffrono di derive identitarie, artefatti visivi o incoerenze dello sfondo o dell’illuminazione, limiti che Lynx mitiga grazie al suo disegno architetturale.
Risulta interessante notare che Lynx offre una variante “lite” priva dell’adattatore Ref, pensata per generare video a 24 fps (121 fotogrammi) con un carico computazionale ridotto, sacrificando in parte la precisione dei dettagli pur mantenendo l’identità e la coerenza temporale. Nel panorama delle ricerche contemporanee, progetti come Magic Mirror introducono metodi alternativi per preservare l’identità nei video generativi usando adattatori leggeri o strategie a due stadi, evidenziando che mantenere stabile il volto pur producendo movimento naturale rimane una sfida condivisa. Altri lavori recenti come LaVieID e MoCA propongono modalità locali o miscele di attenzione incrociata per migliorare consistenza spaziale e temporale nei modelli DiT. Se da un lato Lynx mostra che un disegno basato su adattatori è efficace, dall’altro il contesto di ricerca è in fermento, con nuove vie che esplorano decomposizioni in frequenza o moduli autoregressivi locali per raffinare ulteriormente la coerenza facciale. Una delle sfide pratiche è la scalabilità a video più lunghi o ad ambienti complessi con interazioni dinamiche estese: l’efficacia del modello in scenari con molteplici soggetti, cambiate d’illuminazione rapide o azioni complesse non è ancora ben esplorata nei risultati pubblicati. Lynx offre una promessa concreta: passare da un’immagine isolata a un piccolo filmato, mantenendo l’identità viva, con una progettazione elegante e modulare che si presta a futuri miglioramenti e integrazioni.
In ultima analisi, Lynx invita a considerare il volto non come un vincolo ma come un motore narrativo da preservare nel viaggio visivo.