

Volti che danzano, corpi che raccontano: l’arte segreta di Wan-Animate | Stable diffusion ai download | Generatore di immagini online | Da testo a immagine ai | Turtles AI
Volti che danzano, corpi che raccontano: l’arte segreta di Wan-Animate
Un modello che trasforma immagini statiche in performance vive, capace di sostituire personaggi nei video con gesti, espressioni e luci perfettamente intrecciati alla scena, fondendo tecnica e immaginazione in un unico respiro visivo
Editorial Team19 settembre 2025
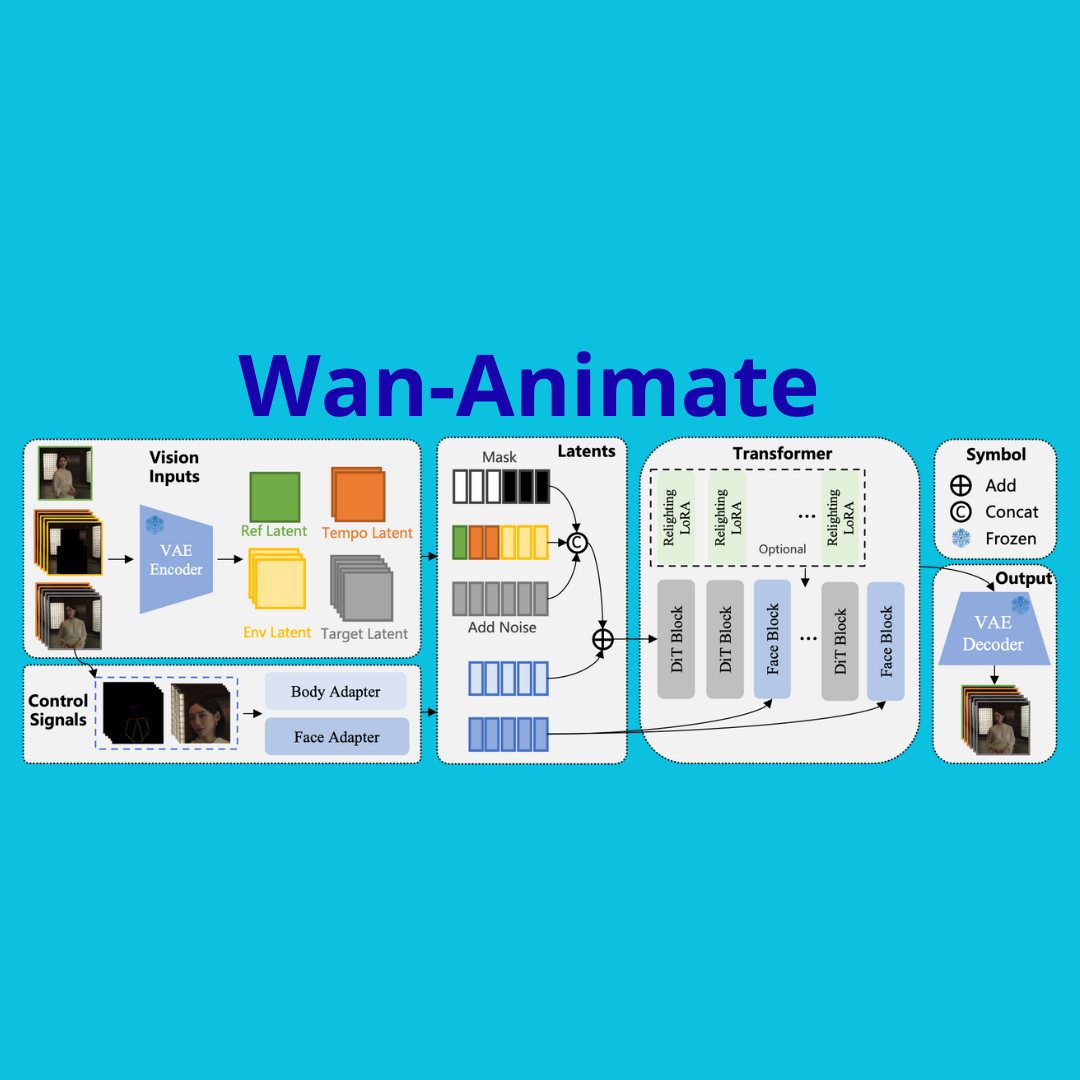
Wan-Animate è un modello all-in-one che anima o sostituisce un personaggio partendo da un’immagine e da un video di riferimento, replicando fedelmente movimenti, espressioni facciali e illuminazione ambientale per video caratterizzati da alta fedeltà visiva.
Punti chiave:
- anima personaggi statici usando video di riferimento
- replica olistica di movimenti del corpo e espressioni facciali
- sostituzione integrata nel video di origine con relighting
- flusso di input unificato e simbolico, grazie a Wan-I2V
Wan-Animate nasce come l’evoluzione di Wan-I2V, trasformando un’immagine statica di un personaggio in un video espressivo grazie a una guida sequenziale che combina segnali scheletrici spazialmente allineati e caratteristiche facciali implicite estratte dal volto dell’artista. l Il risultato è un’animazione dove il personaggio replica fedelmente movimenti e emozioni, con grande controllo e realismo.
Ma non è tutto: se si desidera inserire quel personaggio in un video esistente al posto di un altro, il modello agisce in modalità “replacement”. In questo caso, un modulo ausiliario chiamato Relighting LoRA interviene per adattare l’illuminazione e il tono colore del personaggio al contesto, garantendo una fusione visivamente armoniosa nella scena originale.
L’architettura si basa su un paradigma di input modificato rispetto a Wan-I2V: le condizioni di riferimento, le regioni da generare e il contesto ambientale vengono rappresentati simbolicamente in modo compatto. I segnali scheletrici guidano il corpo, mentre le espressioni facciali vengono gestite separatamente tramite vettori latenti ottenuti da immagini di volti che agiscono tramite attenzione incrociata. Questo approccio consente una formazione condivisa per le due modalità (animazione e sostituzione), migliorando coerenza e prestazioni.
I risultati sperimentali mostrano che Wan-Animate raggiunge livelli generalmente superiori rispetto a soluzioni proprietarie come Runway Act-two o DreamActor-M1. In studi soggettivi, quando utenti confrontano video generati affiancati, la preferenza cade spesso sul risultato prodotto da Wan-Animate, grazie alla migliore fedeltà all’identità, movimento ed espressione. In particolare, il modulo Relighting LoRA si distingue per la capacità di preservare l’identità del personaggio pur adattandolo visivamente all’illuminazione e al tono della scena di destinazione.
Potrebbero emergere applicazioni creative: riprodurre performance classiche con personaggi differenti, trasferire performance umane a avatar stilizzati, sintetizzare complessi movimenti di danza, supportare scene con camere dinamiche o ambienti diversi, o riscrivere scene filmiche sostituendo personaggi con coerenza visuale complessiva. La promessa è di mettere a disposizione community open-source pesi del modello e codice, permettendo agli sviluppatori di creare strumenti innovativi e applicazioni creative con elevata qualità visiva.
Wan-Animate rappresenta un approccio integrato: un unico modello, una pipeline unificata, due modalità operative (animazione e sostituzione), controllo multi-canale su corpo, volto e ambiente; il tutto pronto all’uso mediante codice e pesi liberamente disponibili.
La sua forza sta nella capacità di generare video di personaggi altamente realisti, mantenendo identità, espressività e armonia ambientale, pur operando in contesti diversi e con personaggi arbitrari.